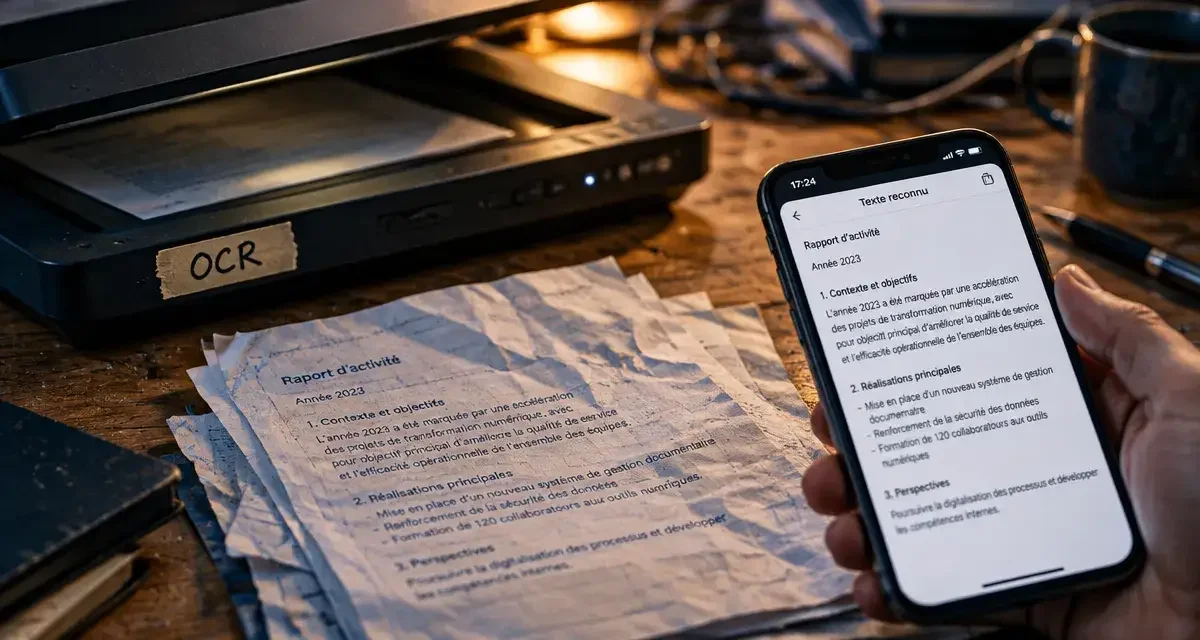
La reconnaissance optique de caractères, plus connue sous l’acronyme OCR, est une technologie qui convertit des documents numérisés, des photographies ou des fichiers PDF en texte éditable et consultable. Elle agit comme un pont entre le monde physique du papier et l’univers numérique des bases de données, permettant de traiter des informations autrefois figées sur un support matériel.
Comprendre l’OCR : définition et utilité
L’OCR est un processus informatique qui analyse les formes, les courbes et les agencements de pixels composant des caractères typographiques sur une image pour les traduire en codes informatiques, tels que l’ASCII ou l’Unicode. Sans cette technologie, un document scanné reste une image statique, impossible à modifier, à indexer par mot-clé ou à intégrer dans un logiciel de traitement de texte.
L’utilité de l’OCR dépasse la simple conversion de fichiers. Elle permet aux organisations d’automatiser des processus longs, comme la saisie manuelle de factures, l’archivage de contrats juridiques ou l’extraction de données depuis des formulaires administratifs. En transformant des documents papier en informations numériques, l’OCR devient un levier de productivité et d’accessibilité.
Le fonctionnement technique : de l’image au texte
Le processus de reconnaissance optique repose sur une succession d’étapes algorithmiques précises, garantissant la fidélité de la retranscription finale.
Acquisition et prétraitement
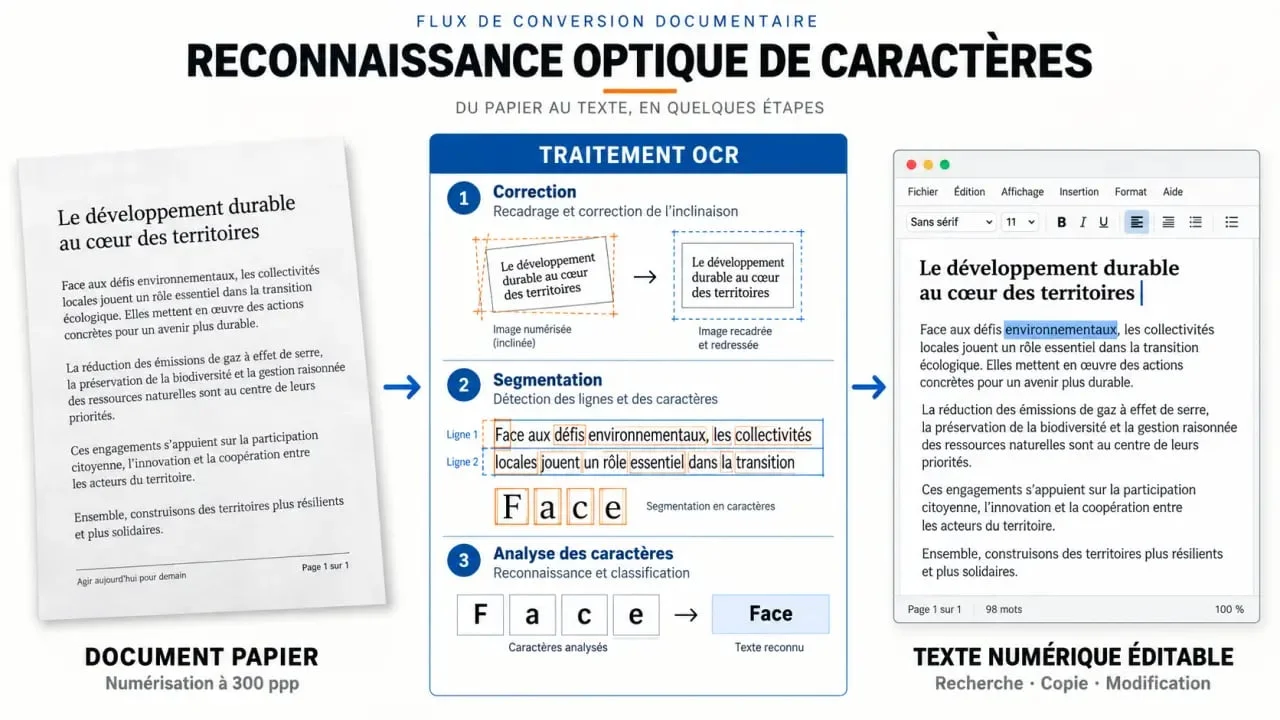
Tout commence par l’acquisition de l’image. Lors d’un scan ou d’une capture, le système reçoit des informations lumineuses traduites en une matrice numérique. Cette étape transforme le signal physique en donnée mathématique, permettant aux algorithmes d’isoler les glyphes du bruit de fond. Avant l’analyse, le logiciel effectue un prétraitement : il redresse l’image, supprime les taches, ajuste le contraste et binarise le document pour séparer distinctement le texte du fond.
Reconnaissance de motifs et de caractéristiques
Une fois l’image nettoyée, le logiciel utilise deux approches principales. La reconnaissance de motifs compare chaque forme identifiée à une bibliothèque de glyphes connus (lettres, chiffres, symboles). La reconnaissance de caractéristiques, plus avancée, analyse les composants structurels comme les traits, les angles, les boucles et les intersections. Cette méthode permet au système d’identifier des caractères même si la police est inhabituelle ou si le document présente des imperfections d’impression.
Applications concrètes et bénéfices métiers
Les secteurs d’activité utilisant l’OCR sont nombreux. Dans le secteur bancaire et financier, l’OCR est utilisé pour la lecture automatique des chèques et le traitement des factures fournisseurs, ce qui limite les erreurs de saisie humaine. Dans le domaine juridique, il facilite la numérisation et l’indexation de milliers de pages d’archives, permettant une recherche instantanée au sein de vastes bibliothèques de documents.
Pour le grand public, l’OCR est devenu omniprésent. Il permet, via des applications mobiles, de scanner un ticket de caisse pour gérer ses dépenses, de traduire instantanément un panneau de signalisation en langue étrangère, ou de numériser des notes manuscrites pour les rendre éditables sur ordinateur. Le gain de temps est le bénéfice premier, doublé d’une réduction des coûts opérationnels liés à la gestion documentaire.
OCR, ICR et OMR : distinguer les technologies
Il est fréquent de confondre l’OCR avec d’autres technologies de reconnaissance, bien que leurs usages diffèrent. L’OCR se concentre sur les caractères imprimés, offrant une précision élevée pour les polices standards. L’ICR (Intelligent Character Recognition) représente une évolution de l’OCR, capable de reconnaître l’écriture manuscrite, bien que celle-ci reste plus complexe à traiter en raison de la variabilité des graphies humaines.
De son côté, l’OMR (Optical Mark Recognition) a une fonction plus restreinte : il est conçu pour détecter la présence ou l’absence de marques dans des zones prédéfinies, comme les cases à cocher sur des questionnaires ou des QCM. Alors que l’OCR extrait du texte, l’OMR valide des choix binaires. Ces trois technologies sont souvent combinées au sein de solutions logicielles globales pour permettre une gestion documentaire automatisée complète.
Limites, enjeux et évolutions de l’OCR
Malgré des progrès technologiques, l’OCR rencontre des limites liées à la qualité des documents sources. Un document froissé, une impression de faible qualité ou une police trop stylisée peuvent altérer la précision du résultat. Les documents présentant des colonnes complexes, des tableaux imbriqués ou des images superposées au texte posent également des défis techniques aux algorithmes classiques.
L’avenir de l’OCR réside dans l’intégration de l’intelligence artificielle et du deep learning. Ces nouvelles approches permettent aux systèmes d’apprendre du contexte, améliorant la reconnaissance des caractères dans des environnements difficiles. La question de la sécurité des données extraites devient centrale, imposant aux solutions OCR modernes d’intégrer des protocoles de chiffrement robustes pour protéger les informations sensibles durant tout le processus de traitement.