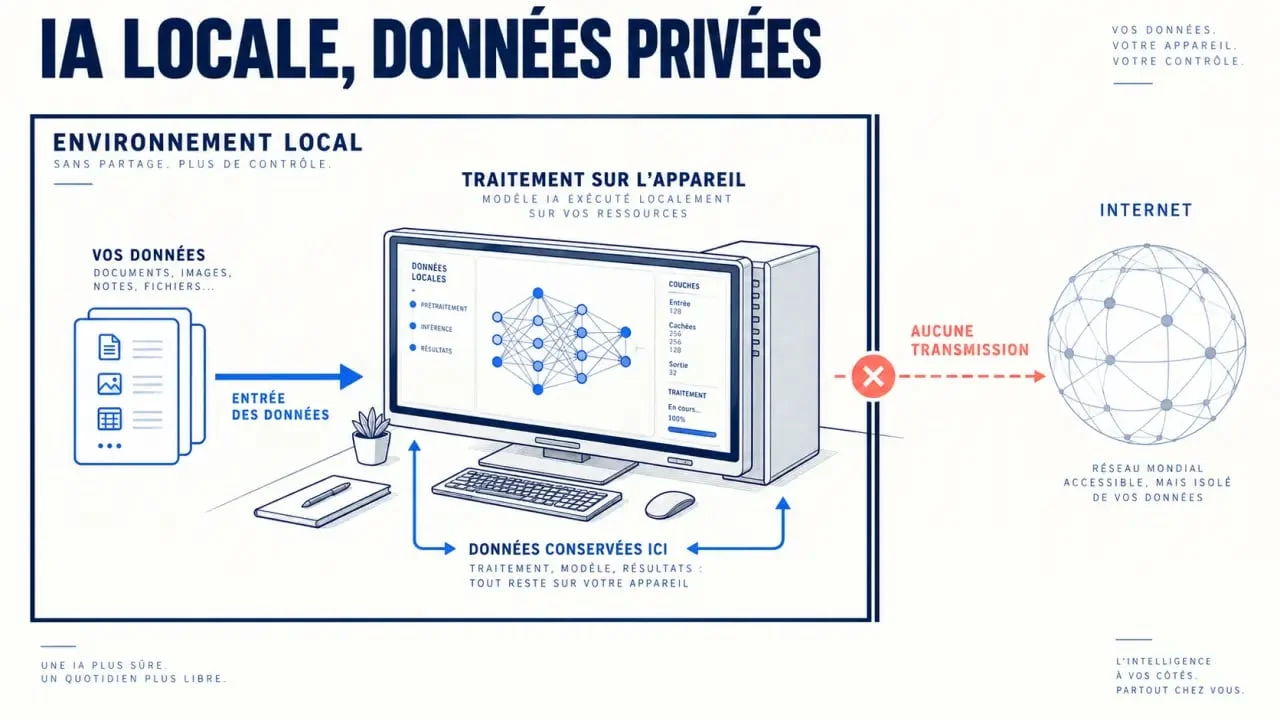
Installer une intelligence artificielle directement sur votre ordinateur permet de s’affranchir des contraintes imposées par les services cloud. En exécutant des modèles de langage (LLM) en local, vous garantissez une confidentialité totale, car vos données ne quittent jamais votre machine, tout en supprimant les coûts récurrents liés aux abonnements premium.
Pourquoi privilégier une installation en local ?
Le choix d’une solution locale repose sur trois piliers : la sécurité, la gratuité et l’indépendance. Contrairement aux services en ligne, une IA locale fonctionne sans connexion Internet, ce qui la rend utilisable dans n’importe quel environnement. Elle vous protège contre les fuites de données confidentielles, un atout majeur pour les professionnels manipulant des documents sensibles.
Sur le plan technique, l’installation d’un modèle offre une grande modularité. Une fois le moteur d’inférence en place, vous pouvez facilement ajouter des extensions, connecter vos propres documents via le RAG (Retrieval Augmented Generation) ou créer des interfaces personnalisées. Cette approche permet d’adapter l’outil à vos besoins spécifiques plutôt que de subir les limitations d’une interface standardisée. Vous conservez ainsi la main sur les paramètres de température, de contexte et de comportement du modèle.
Les prérequis matériels indispensables
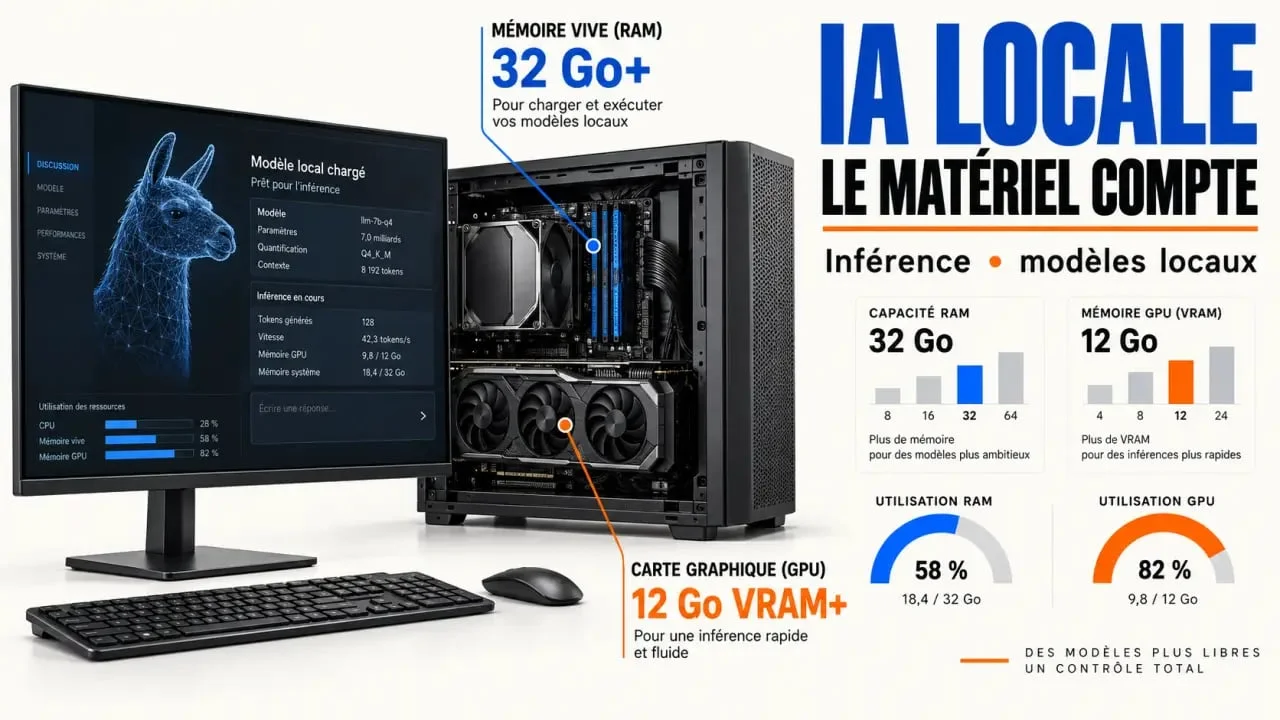
Faire tourner une IA nécessite une configuration solide. La mémoire vive (RAM) est le premier facteur limitant. Il est recommandé de disposer d’au moins 8 Go de RAM, bien que 16 Go soient nettement plus confortables pour des modèles récents. La carte graphique joue un rôle déterminant : une VRAM de 6 à 8 Go permet d’accélérer considérablement la vitesse de génération des réponses grâce aux cœurs CUDA ou ROCm.
Si vous ne possédez pas de carte graphique puissante, le processeur peut prendre le relais, bien que la vitesse de traitement soit alors réduite. Les modèles optimisés au format GGUF sont conçus pour s’adapter dynamiquement à ces ressources. Ils permettent de charger des modèles allant de 350 Mo pour les plus légers, comme Baguettotron, jusqu’à 8 Go pour des modèles 7B plus performants comme Mistral ou Llama 3. Cette flexibilité rend l’IA locale accessible sur une large gamme de machines, des portables bureautiques aux stations de travail spécialisées.
Choisir le bon outil : LM Studio ou Ollama
Le choix de l’outil dépend de votre aisance technique. Pour les utilisateurs privilégiant une interface graphique intuitive, LM Studio est la solution idéale. Il permet de rechercher, télécharger et tester des modèles en quelques clics, tout en offrant une gestion visuelle des paramètres techniques comme le nombre de jetons ou la taille du contexte.
Pour ceux qui préfèrent une approche plus légère ou une intégration via ligne de commande, Ollama est devenu le standard de fait. Il agit comme un serveur local capable de servir des modèles via une API, ce qui facilite l’intégration de l’IA dans vos propres applications, sites web ou projets domotiques. Il s’installe très rapidement sur Windows, macOS et Linux et gère efficacement la mémoire système.
Guide d’installation pas à pas
Pour débuter avec LM Studio, la procédure est directe :
Téléchargez l’exécutable depuis le site officiel et installez-le. Ouvrez l’interface et utilisez la barre de recherche pour trouver un modèle, par exemple « Llama 3 » ou « Mistral ». Sélectionnez une version quantifiée, souvent notée Q4 ou Q5, pour obtenir un équilibre optimal entre performance et poids du fichier. Une fois le téléchargement terminé, rendez-vous dans l’onglet « Chat » pour sélectionner votre modèle et commencer la conversation.
Si vous optez pour Ollama, téléchargez le programme, puis lancez la commande « ollama run llama3 » dans votre terminal. Le logiciel gère automatiquement le téléchargement et le démarrage. Vous pourrez ensuite installer une interface comme Open WebUI pour retrouver une expérience utilisateur proche de celle des plateformes cloud les plus connues, avec une gestion historique de vos échanges.
Dépannage et optimisation des performances
Si vous constatez des lenteurs, vérifiez que votre modèle n’est pas trop volumineux pour votre mémoire disponible. Une astuce consiste à utiliser des modèles plus légers comme Phi-3 ou des versions de modèles plus fortement quantifiées. Assurez-vous également que vos pilotes graphiques sont à jour pour supporter les technologies CUDA sur Nvidia ou ROCm sur AMD, essentielles pour décharger le processeur.
N’hésitez pas à explorer les forums spécialisés comme r/LocalLLaMA sur Reddit pour échanger sur les meilleures configurations. L’écosystème évolue rapidement, et des modèles comme Ministral ou Qwen 3.5 offrent aujourd’hui des capacités impressionnantes pour une consommation de ressources maîtrisée. En maîtrisant ces outils, vous prouvez qu’il n’est pas nécessaire de disposer d’un serveur professionnel pour obtenir des résultats de haute qualité tout en gardant une maîtrise totale sur vos données privées.