Lorsqu’un acteur aussi central que Cloudflare subit une interruption de service, une large partie du Web cesse de fonctionner. Avec plus de 330 datacenters répartis dans 120 pays et une gestion quotidienne de 80 millions de requêtes HTTP chaque seconde, l’infrastructure de l’entreprise est devenue la colonne vertébrale de l’Internet moderne. L’incident survenu le 18 novembre 2025 rappelle aux professionnels du numérique comme aux utilisateurs finaux que notre dépendance à ces services est devenue systémique.
Anatomie d’une défaillance : les causes techniques
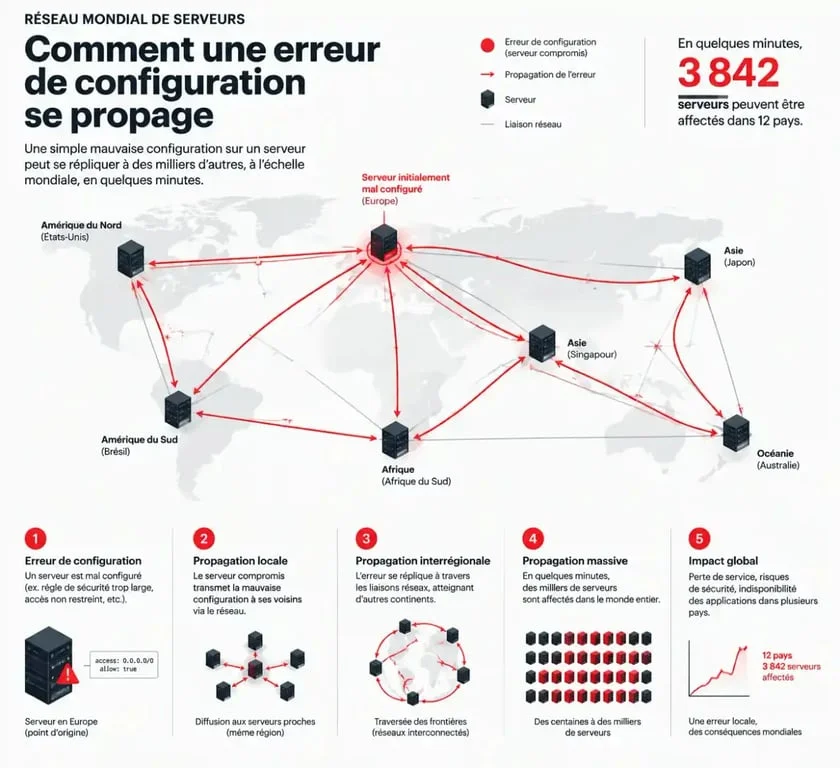
L’incident ne résulte pas d’une cyberattaque ou d’une activité malveillante. L’analyse post-mortem révèle une défaillance interne liée à une modification des permissions dans une base de données. Ce changement, en apparence mineur, déclenche une réaction en chaîne au sein du réseau mondial.
Le rôle du fichier de fonctionnalités
Le problème survient lorsqu’un fichier de fonctionnalités, destiné à la gestion avancée des bots, devient trop volumineux pour être traité par les systèmes de contrôle. Cette surcharge dépasse les limites logicielles prévues, entraînant une instabilité immédiate du réseau. Le système, conçu pour protéger le trafic, finit par le bloquer par excès de zèle.
La propagation de l’erreur
La défaillance se propage rapidement à travers les différents points de présence de Cloudflare. À mesure que les serveurs tentent de charger la nouvelle configuration, ils se heurtent à la même limite, provoquant des erreurs généralisées pour les internautes accédant aux sites protégés. Ce comportement en cascade est caractéristique des systèmes hautement interconnectés où une erreur de configuration unique paralyse des milliers de services simultanément.
Un écosystème sous pression : l’ampleur de l’impact
Les conséquences de cette panne sont visibles instantanément. Avec environ 25 % du trafic Internet mondial transitant par les infrastructures de Cloudflare, l’impact sur l’économie numérique est massif. Plus de 5 000 signalements sont enregistrés sur DownDetector au pic de l’incident, illustrant l’étendue de la frustration des utilisateurs et des administrateurs système.
Services touchés et conséquences financières
De nombreux services web critiques deviennent inaccessibles pendant environ trois heures. Si aucune perte de données ou faille de sécurité n’est déplorée, le coût économique est notable. Pour une entreprise dont le chiffre d’affaires annuel atteint 2,1 milliards de dollars en 2025, une interruption de service se traduit par un manque à gagner estimé à environ 333 000 dollars de revenus par heure d’indisponibilité, sans compter les pertes indirectes pour les entreprises clientes dépendantes de cette plateforme pour leur propre activité.
Gestion de crise et transparence
Cloudflare identifie et corrige la propagation du fichier défectueux en quelques heures. La communication est rapide, une nécessité absolue pour maintenir la confiance des clients B2B. Cette gestion de crise permet d’éviter une panique prolongée sur les marchés financiers, bien que l’action de l’entreprise subisse une variation temporaire d’environ 1,4 % durant la période de perturbation.
Vers une résilience numérique renforcée
La question de la dépendance aux CDN (Content Delivery Network) est désormais au centre des discussions stratégiques. La panne agit comme une fenêtre ouverte sur la fragilité de nos infrastructures : elle permet de voir ce qui se passe à l’intérieur, là où la complexité technique reste invisible. En observant cette défaillance, les entreprises réalisent que la dépendance à un seul fournisseur, aussi performant soit-il, crée un point de défaillance unique qu’il est urgent de repenser pour garantir la continuité des activités.
Stratégies de diversification
Pour limiter l’impact de futurs incidents, plusieurs recommandations émergent pour les responsables IT. La première consiste à instaurer une redondance multi-CDN, en utilisant plusieurs fournisseurs de distribution de contenu pour basculer automatiquement le trafic en cas de panne majeure. La seconde implique un audit rigoureux des configurations, avec des tests de charge systématiques avant de déployer des modifications sur des fichiers de fonctionnalités complexes. Enfin, les entreprises doivent maintenir des plans de continuité prévoyant des procédures de secours manuelles lorsque les systèmes automatisés de gestion du trafic deviennent défaillants.
Ce qu’il faut retenir pour l’avenir
L’incident du 18 novembre 2025 reste un cas d’école sur la gestion des infrastructures critiques. Il sert de stress test involontaire pour l’Internet mondial. Si Cloudflare demeure un outil efficace pour la performance et la sécurité web, l’événement souligne que la résilience ne repose pas uniquement sur la robustesse d’un seul fournisseur, mais sur la capacité des organisations à anticiper l’imprévisible. La leçon est claire : dans un monde hyperconnecté, l’agilité technique doit toujours être doublée d’une stratégie de défense en profondeur.