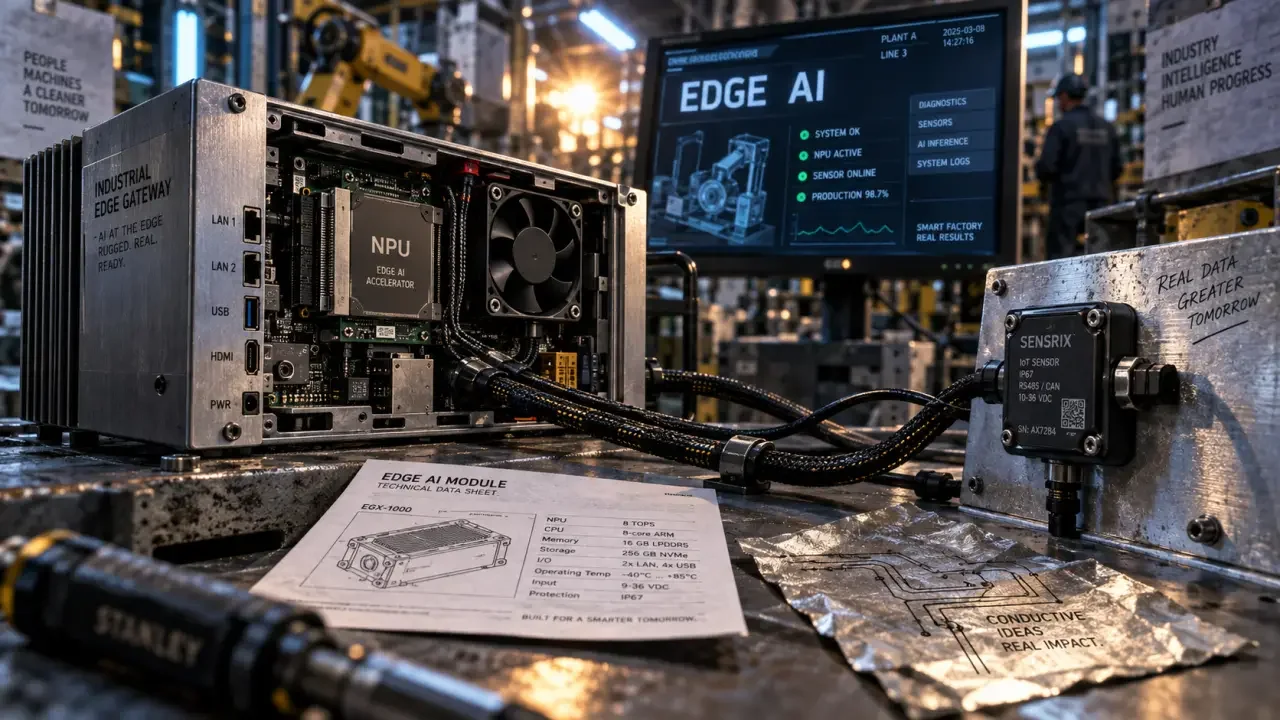
L’Edge AI, ou intelligence artificielle en périphérie, modifie la gestion des données industrielles et technologiques. Contrairement aux modèles classiques qui imposent un transfert massif d’informations vers des serveurs centraux, l’Edge AI déporte les capacités de calcul directement sur les appareils locaux. Cette approche permet de traiter l’inférence, le moment où l’IA prend une décision, en quelques millisecondes, au plus proche de la source des données.
Le fonctionnement technique : de l’entraînement à l’inférence
L’architecture de l’Edge AI repose sur une distinction claire entre deux phases du cycle de vie du machine learning. L’entraînement, extrêmement gourmand en ressources, reste généralement centralisé dans le cloud ou dans des centres de données puissants. C’est ici que les modèles apprennent à partir de volumes massifs de données historiques. Une fois entraîné, le modèle est quantifié ou élagué (pruning) pour être déployé sur des équipements locaux. Cette compression réduit la taille du modèle sans altérer sa précision, permettant son exécution sur des terminaux aux ressources limitées.
Composants matériels et accélération
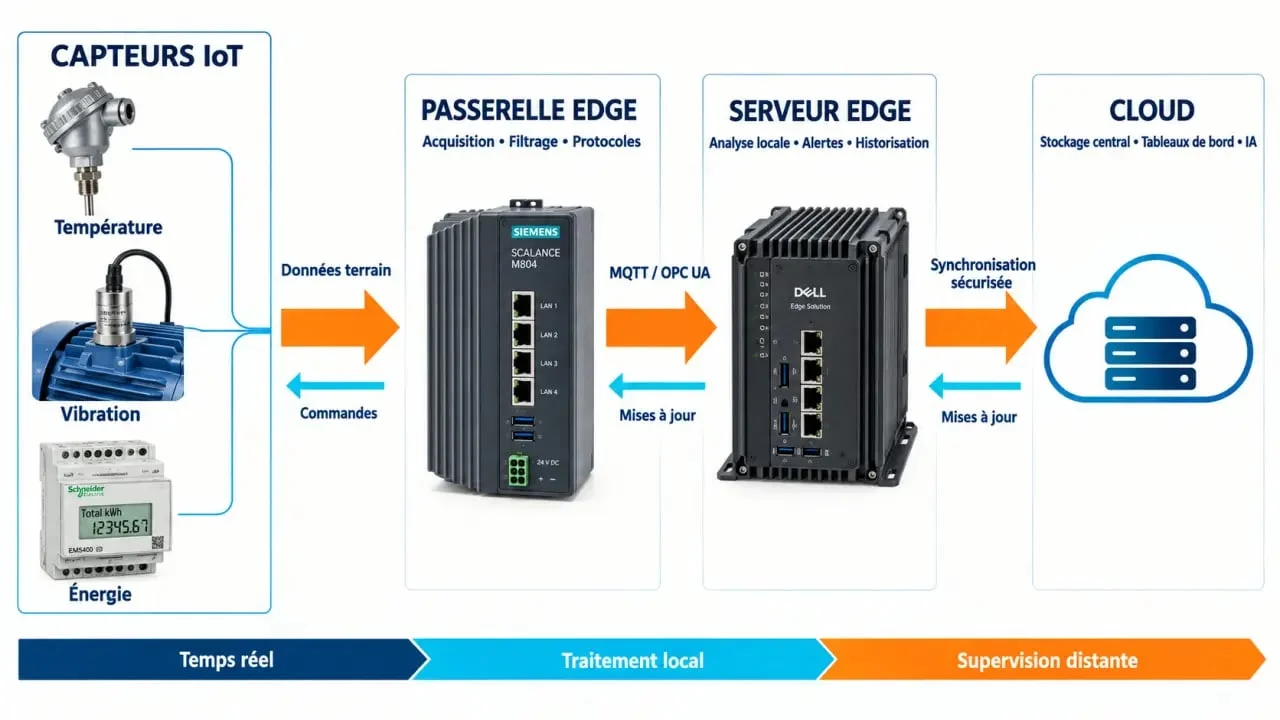
Pour fonctionner efficacement, l’Edge AI s’appuie sur des processeurs spécialisés appelés accélérateurs d’IA. Les NPU (Neural Processing Units) et les GPU optimisés permettent d’exécuter des réseaux de neurones complexes sans saturer la mémoire vive de l’appareil. Ces composants, intégrés dans des passerelles (edge gateways) ou directement dans des capteurs IoT, transforment des dispositifs passifs en unités de calcul autonomes capables de prendre des décisions critiques en temps réel.
Edge AI vs Cloud AI : un comparatif stratégique
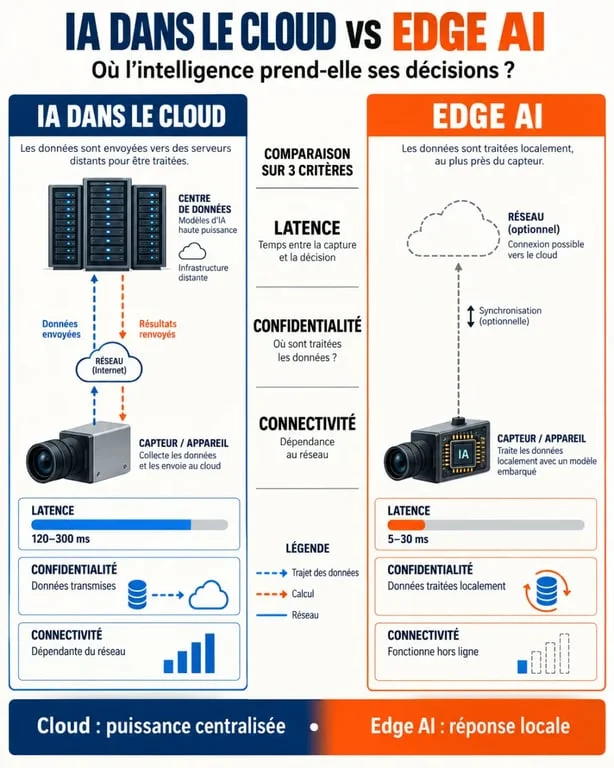
Le choix entre une architecture centralisée et une approche décentralisée dépend largement des contraintes métier. L’Edge AI privilégie la réactivité immédiate, tandis que le Cloud AI reste idéal pour le traitement de données historiques à grande échelle.
| Critère | Cloud AI | Edge AI |
|---|---|---|
| Latence | Élevée (dépend du réseau) | Faible (millisecondes) |
| Connectivité | Requise en permanence | Optionnelle |
| Confidentialité | Données transférées | Traitement local (privé) |
| Coûts bande passante | Élevés | Faibles |
Pourquoi privilégier l’Edge AI dans vos architectures ?
L’adoption de l’Edge AI répond à des enjeux de résilience et de souveraineté numérique. Dans un écosystème où la gravité des données pousse les organisations à centraliser leurs informations, l’Edge AI réoriente la puissance de calcul vers l’origine même de l’information. Cette stratégie garantit que le système reste opérationnel même en cas de défaillance réseau, évitant la dépendance totale à des serveurs distants.
Sécurité et conformité
En conservant les données sensibles sur le site de production ou sur l’appareil utilisateur, l’Edge AI facilite la conformité aux réglementations strictes comme le RGPD ou les normes de santé. Le risque d’interception des données lors du transfert est mécaniquement réduit, transformant la sécurité en un élément natif de l’architecture plutôt qu’en une couche logicielle ajoutée a posteriori.
Cas d’usage sectoriels
L’Edge AI trouve des applications concrètes dans des secteurs exigeants. Dans l’industrie, elle permet la maintenance prédictive en analysant les vibrations des machines en temps réel pour détecter une panne avant qu’elle ne survienne. Dans le domaine de la santé, des dispositifs portables analysent les signes vitaux instantanément, alertant le patient sans transmettre ses données médicales privées sur le web. Enfin, dans les véhicules autonomes, la capacité à traiter les images de la route en quelques millisecondes est une condition sine qua non de sécurité.
Tendances émergentes et innovations
Le marché de l’Edge AI, projeté pour atteindre 118,69 milliards de dollars d’ici 2033, est porté par des avancées majeures qui démocratisent l’accès à l’IA sur le terrain. Le TinyML, par exemple, permet d’exécuter des modèles d’apprentissage automatique sur des microcontrôleurs consommant quelques milliwatts seulement. Parallèlement, le federated learning offre la possibilité d’améliorer les modèles globaux en agrégeant les apprentissages locaux sans jamais transférer les données brutes, préservant ainsi l’anonymat des utilisateurs tout en affinant la précision globale de l’IA.
Défis de déploiement
La gestion d’une flotte de dispositifs Edge présente des défis réels. La complexité de la mise à jour des modèles à distance, la sécurité physique des terminaux exposés et la gestion de l’hétérogénéité matérielle imposent de structurer une stratégie d’MLOps robuste. L’enjeu pour les décideurs IT est désormais de passer d’un déploiement expérimental à une scalabilité industrielle, où chaque capteur devient un maillon intelligent d’une chaîne de décision décentralisée. La réussite repose sur une surveillance proactive et une automatisation rigoureuse du cycle de vie des modèles déployés.